
Il 16 ottobre 2026 Lenovo Press ha pubblicato la scheda tecnica di Lenovo Sovereign AI Inference, un’architettura per l’IA on-premise costruita con IBM e NVIDIA. L’obiettivo è che tutta l’inferenza avvenga su macchine dell’azienda: la domanda dell’utente, i documenti presi dagli archivi interni, i calcoli intermedi del modello e la risposta non devono passare per forza da un servizio esterno (Lenovo Press).
Se in azienda usi già assistenti IA in cloud e ti chiedi dove finiscono i documenti che ci carichi, l’IA on-premise è l’alternativa da mettere sul tavolo. Qui sotto trovi cosa contiene la soluzione, a chi è rivolta e da dove si può partire senza comprare subito un cluster.
Lenovo non boccia il cloud: per una prova o per carichi che vanno e vengono resta la scelta comoda. Il discorso cambia quando l’IA diventa uno strumento di tutti i giorni, come un assistente interno o un sistema che legge e riassume documenti. A quel punto pesano di più la latenza, la libertà di scegliere il modello e una spesa prevedibile. La scheda raccoglie queste esigenze sotto la parola sovranità e le divide in quattro parti:
Gli esempi della scheda toccano settori diversi, ognuno con un motivo suo. Una banca deve rispettare regole precise su dove stanno i dati. Un ospedale deve proteggere le cartelle dei pazienti e poter dimostrare chi le ha consultate. Nel pubblico e nella difesa capita che i sistemi non possano proprio collegarsi a internet. In fabbrica serve una risposta rapida anche quando la linea esterna non c’è, mentre per uno studio legale il punto è il segreto professionale.
La soluzione per l’IA on-premise fa parte di Lenovo Hybrid AI Factory, la stessa famiglia di architetture di cui abbiamo parlato a proposito di Lenovo AI Express con NVIDIA. Ogni produttore porta un pezzo: Lenovo i server, IBM lo storage e alcuni strumenti software, NVIDIA il software di inferenza e la rete.
| Componente | Cosa prevede la scheda Lenovo |
|---|---|
| Server | Nodi GPU della famiglia Lenovo Hybrid AI Factory, fino a 8 GPU ciascuno su progetti NVIDIA, affiancati da server x86 senza GPU per gateway e gestione |
| Storage | IBM Storage Scale, in versione software (ECE) su server Lenovo con molti dischi oppure come sistema dedicato Storage Scale System 6000 |
| Rete | Ethernet NVIDIA Spectrum-X, con DPU BlueField e schede RoCE |
| Inferenza | NVIDIA Dynamo e vLLM per servire i modelli, LMCache e NIXL/UCX per la cache, LiteLLM per smistare le richieste |
| Applicazioni pronte | Ricette di installazione per NVIDIA AI-Q, Video Search and Summarization (VSS) e IBM OpenRAG, con LangFlow per disegnare i flussi |
| Modelli | Open-weight o open source, purché stiano nella memoria delle GPU scelte |
| Piattaforma | Kubernetes, su Ubuntu o Red Hat |
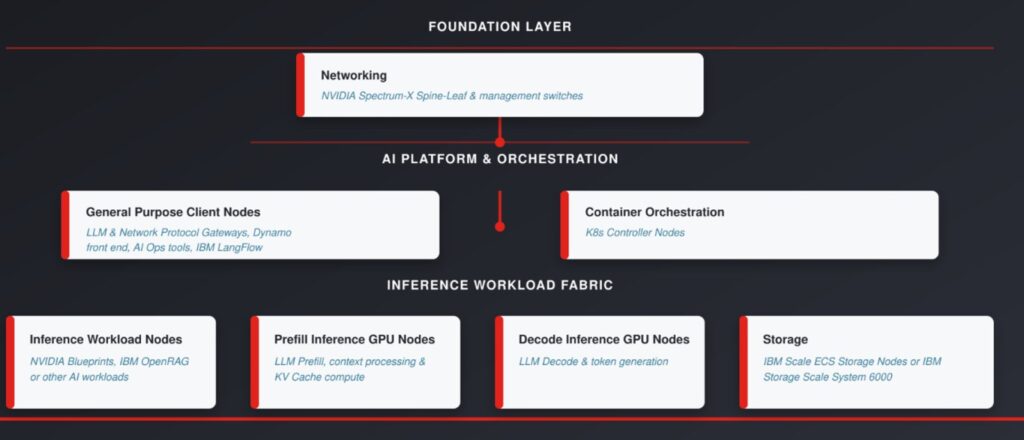
Quando un modello risponde lavora in due fasi. Nel prefill legge la domanda e il contesto, nel decode genera la risposta un token alla volta. Lenovo le assegna a nodi GPU diversi, che si possono aumentare separatamente: più nodi di prefill se i documenti da leggere sono lunghi, più nodi di decode se crescono le conversazioni contemporanee.
Per non rileggere ogni volta lo stesso contesto, il modello mette da parte i risultati intermedi in quella che si chiama cache KV. Di norma la tiene nella memoria HBM della GPU, che si riempie in fretta. La soluzione Lenovo ne sposta una parte sullo storage IBM: le GPU rifanno meno calcoli già fatti e, sempre secondo Lenovo, reggono più utenti contemporanei. Sullo stesso storage finiscono anche modelli, documenti e log, gestiti con un’unica politica per permessi, cifratura e controlli.
Vuoi capire quante GPU servono davvero per i tuoi utenti e i tuoi documenti? Scrivici: partiamo dai casi d’uso e dai dati che non vuoi far uscire dall’azienda.
Per provare l’IA on-premise prima di investire, Lenovo propone un singolo nodo con NVIDIA AI-Q Blueprint, IBM OpenRAG e LangFlow, e rimanda alla guida Lenovo Validated Design Hybrid AI 281 with IBM. Quella guida usa un server Lenovo ThinkSystem SR675 V3 con schede NVIDIA RTX Pro 6000 Blackwell Server Edition e lo propone per progetti RAG, cioè assistenti che rispondono consultando i documenti aziendali, quando si vuole contenere la spesa, sia in sala server sia in una sede periferica (Lenovo Validated Design LP2550).
Per l’IA on-premise in produzione la scheda descrive un cluster Kubernetes in cui ogni ruolo cresce per conto suo. Per partire servono:
Il lavoro di progetto e di gestione Lenovo lo offre con Lenovo AI Services. Si parte dall’analisi dei dati e dal calcolo delle risorse, si passa a installazione e collaudo e si continua dopo l’avvio, quando c’è da ritarare o allargare il sistema, anche dove manca la connessione. Per questa soluzione di IA on-premise la scheda non indica prezzi né tempi di consegna.
Siamo rivenditori Lenovo e seguiamo progetti di IA on-premise per aziende che vogliono usare l’intelligenza artificiale senza mandare fuori i propri dati. Con VMS’S Group puoi:
Significa eseguire i modelli di intelligenza artificiale su server installati in azienda o in un data center scelto dall’azienda, invece di inviare ogni richiesta a un servizio cloud esterno.
IBM fornisce lo storage Storage Scale, che ospita anche la cache KV, e strumenti come OpenRAG. NVIDIA fornisce il software di inferenza Dynamo, i Blueprint AI-Q e VSS e la rete Spectrum-X con DPU BlueField. Lenovo mette i server e i servizi di installazione e supporto.
La scheda non impone un modello preciso: va bene qualunque modello open-weight o open source, anche personalizzato, purché la memoria delle GPU basti a contenerlo.
Sì. Lenovo prevede anche installazioni scollegate da internet o del tutto isolate (air-gap).
Vuoi portare l’IA on-premise nella tua azienda?
Raccontaci quali dati usi e quante persone lavoreranno con l’IA. Ti ricontattiamo per valutare insieme configurazione, tempi e preventivo: il modulo è qui sotto.